YOLO используют там, где нужно находить объекты на изображении или в видеопотоке с небольшой задержкой: на производстве, в ритейле, системах безопасности и робототехнике. Разберем, как устроена работа детектора, как подготовить данные, оценить качество и выбрать модель под конкретное оборудование — от первого знакомства с YOLO до подготовки пилотного проекта.
Как устроен YOLO
YOLO (You Only Look Once) — семейство моделей для обнаружения объектов на изображениях и видео. Чтобы понять, что такое YOLO, важно знать главное отличие этого подхода: модель за один проход определяет, какие объекты находятся в кадре и где именно.
YOLO относится к одностадийным детекторам. В исходной работе 2015 года этот подход отличался от двухэтапных схем, которые сначала находят области изображения с потенциальными объектами, а затем определяют, что именно в них находится.
Сейчас существует несколько реализаций YOLO с разной архитектурой. Они отличаются размером, скоростью и требованиями к оборудованию. Поэтому модели лучше сравнивать на своих данных и на том оборудовании, где они будут работать.
Что модель видит на изображении
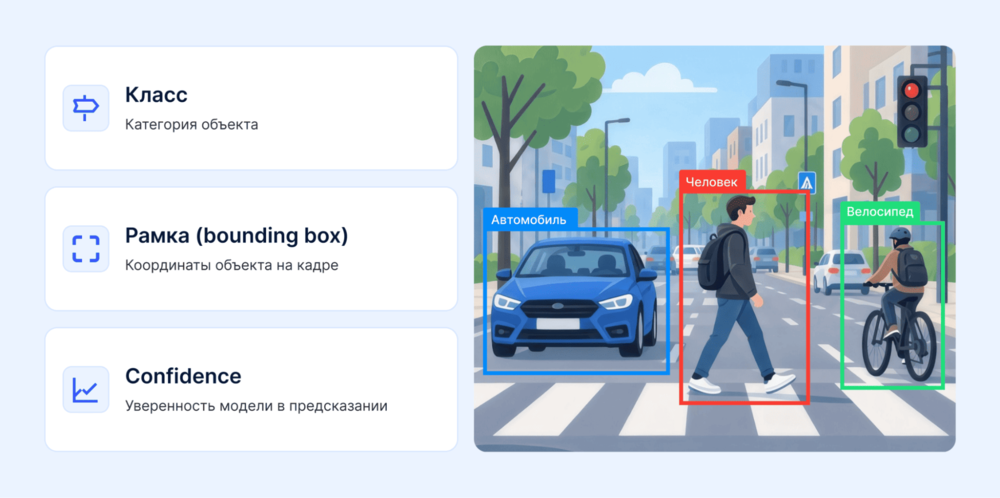
Для каждого найденного объекта модель YOLO определяет:
- Класс — к какой категории относится объект.
- Bounding box, или ограничивающая рамка, — где объект находится на изображении.
- Confidence — насколько модель уверена в предсказании. По этому показателю можно отфильтровать слабые срабатывания.
Например, нейросеть YOLO может найти в кадре три автомобиля и человека. Для каждого объекта она определит класс, координаты рамки и confidence. Если два объекта стоят рядом, детектор должен выделить каждый отдельной рамкой. Если объект частично закрыт, результат зависит от того, встречались ли похожие случаи в обучающих данных и как они были размечены.
Высокий confidence не означает, что модель определила объект правильно. Поэтому порог confidence подбирают на отдельной проверочной (валидационной) выборке с учетом цены ошибки. Например, при контроле опасной зоны пропустить объект обычно критичнее, чем получить лишнюю тревогу. При автоматическом учете товара приоритеты могут быть другими.
Что происходит с кадром во время распознавания
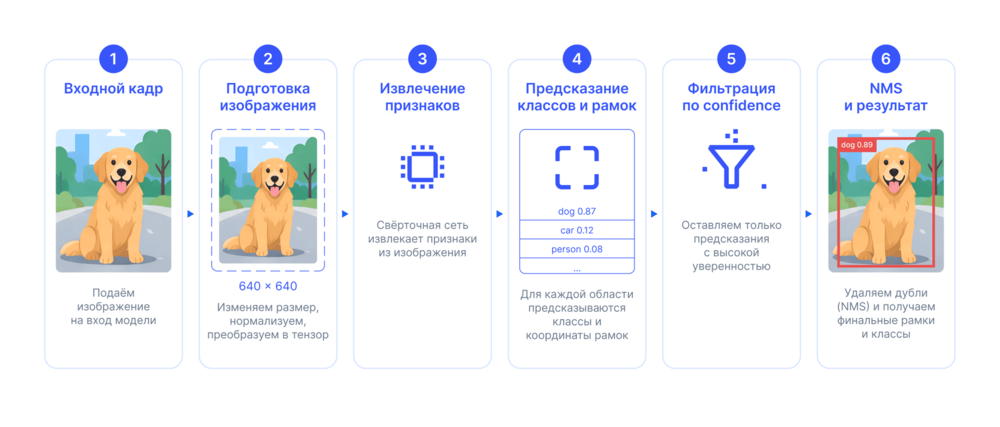
Чтобы понять, как работает YOLO, проследим, что происходит с кадром от загрузки до готового результата.
- Подготовка изображения. Кадр масштабируют до нужного размера, при необходимости добавляют поля и нормализуют значения. Несколько изображений можно объединить в batch и обработать вместе.
- Извлечение признаков. Модель выделяет границы, текстуры, формы и другие признаки, по которым распознает объекты разных размеров.
- Предсказание. Модель определяет классы объектов, координаты рамок и confidence.
- Фильтрация. Предсказания с confidence ниже заданного порога удаляются. Во многих реализациях также используют NMS (non-maximum suppression): алгоритм сравнивает пересекающиеся рамки и убирает дубли.
- Результат. Приложение получает координаты, классы и confidence. Эти данные можно использовать, например, чтобы вести подсчет объектов, включать тревогу, записывать событие или передавать координаты роботу.
Распознавание объектов в реальном времени зависит от скорости всей этой цепочки, а не только от инференса. На общую задержку также влияют декодирование видео, подготовка кадра, передача данных на ускоритель и постобработка.
Где применяют YOLO
YOLO используют в задачах, где объекты нужно находить непосредственно в потоке изображений или видео. Например:
- на производстве — находить дефекты продукции и проверять наличие касок, жилетов и других средств защиты;
- в ритейле — считать посетителей, отслеживать очереди и наличие товаров;
- в логистике — считать коробки, палеты и другие объекты при перемещении;
- в транспортных системах — обнаруживать автомобили, пешеходов и другие объекты на дороге;
- в робототехнике — находить препятствия и объекты, с которыми должен взаимодействовать робот.
Одной детекции для прикладной системы обычно недостаточно. Например, чтобы посчитать автомобили, нужно не только обнаружить их в каждом кадре, но и отслеживать между кадрами, чтобы один автомобиль не посчитался несколько раз. Для контроля опасной зоны после обнаружения человека нужно определить, произошло ли событие, а затем передать его в систему уведомлений.
Почему версии YOLO нельзя сравнивать только по номеру
Название YOLO используют разные команды разработчиков, поэтому версии YOLO v5, v7, v8 и v10 не относятся к одной последовательной линейке. У этих моделей разная архитектура и экосистема, а больший номер не означает, что модель лучше подойдет для конкретной задачи.
На момент публикации Ultralytics рекомендует использовать для новых проектов YOLO26, а YOLO11 — как более зрелую альтернативу. Рекомендации быстро меняются, поэтому перед выбором версии стоит проверить актуальную страницу моделей Ultralytics. При выборе модели учитывают поддержку нужной задачи, форматы экспорта, лицензию и производительность на целевом оборудовании
У моделей Ultralytics есть варианты n, s, m, l и x. Они различаются размером и требованиями к ресурсам: компактные модели обычно быстрее и потребляют меньше памяти, более крупные могут давать более высокое качество, но требуют больше вычислительных ресурсов.
Например, YOLO11n — самый компактный вариант в линейке YOLO11, а YOLO11x — самый крупный. На одном и том же оборудовании YOLO11n обычно работает быстрее, но YOLO11x может точнее распознавать объекты. Подходящий вариант проверяют на своих данных и оборудовании.
Как подготовить датасет для обучения
Для обучения нужен датасет с размеченными объектами. В формате Ultralytics YOLO для каждого объекта указывают номер класса и четыре нормализованные координаты рамки: положение центра по горизонтали и вертикали, ширину и высоту. Значения нормализованы относительно размеров изображения и находятся в диапазоне от 0 до 1.
Например, если на изображении есть автомобиль и человек, для каждого объекта создают отдельную строку с номером класса и координатами его рамки.
Датасет должен включать условия, в которых модель будет работать после запуска: разные ракурсы и расстояния до объектов, освещение, фон, погоду и качество камеры. Если в обучающей выборке есть только крупные автомобили при дневном свете, модель может хуже находить их ночью, издалека или при частичном перекрытии.
Разметка должна быть последовательной. Например, если частично закрытого человека в одних кадрах размечают, а в других пропускают, модель получает противоречивые примеры. То же касается рамок: нужно заранее определить правила и одинаково размечать объекты во всем датасете.
При работе с видео важно правильно разделить данные на train и validation. Соседние кадры часто почти не отличаются, поэтому при случайном распределении отдельных кадров возникает утечка данных: модель может обучаться на одном кадре, а проверяться на почти таком же. Чтобы этого избежать, данные разделяют по видео, времени съемки, камерам или площадкам.
Для первого пилота не обязательно собирать максимально большой датасет. Важнее проверить, хватает ли данных для ключевых рабочих сценариев: модель должна стабильно распознавать нужные классы на отдельной выборке и не проваливаться в отдельных условиях — например, при слабом освещении, частичном перекрытии объектов или съемке с разных камер. Если ошибки регулярно повторяются в одном сценарии, для него стоит собрать и разметить дополнительные примеры.
Как запустить обучение модели
Обучение YOLO обычно начинают с предобученных весов, а затем дообучают модель на своем датасете под нужные классы и условия съемки.
Перед запуском настраивают параметры обучения:
- epoch — сколько раз модель пройдет по всему обучающему датасету;
- batch size — сколько изображений модель обрабатывает за один шаг;
- learning rate — насколько сильно модель корректирует веса на каждом шаге;
- аугментации — какие изменения применяют к обучающим изображениям, например поворот, отражение или изменение яркости;
- imgsz — размер изображения, которое подают на вход модели.
Параметры подбирают с учетом датасета и доступных ресурсов. Например, большой batch size требует больше памяти GPU. Увеличение imgsz позволяет сохранить больше деталей и может помочь при распознавании небольших объектов, но повышает вычислительную нагрузку. Слишком высокий learning rate может мешать обучению, а слишком низкий — увеличивать его продолжительность.
В задачах компьютерного зрения с YOLO обучение модели и серия тестовых прогонов могут требовать значительных ресурсов GPU, особенно при большом датасете или высоком разрешении изображений. Для таких задач можно использовать GPU-серверы Рег.облака: подобрать конфигурацию для обучения, а затем проверить скорость инференса при целевом разрешении и количестве видеопотоков.
Как оценить качество детекции по метрикам
Качество детекции оценивают по нескольким показателям: насколько часто модель правильно распознает объекты, сколько объектов она пропускает и насколько точно определяет их положение.
Precision (доля верных срабатываний) показывает, сколько срабатываний модели оказались правильными. Например, детектор отметил 100 объектов как автомобили, но автомобилями оказались только 90. Precision в этом случае равен 0,9, или 90%.
Recall (доля найденных объектов) показывает, сколько реальных объектов модель смогла обнаружить. Если на изображениях было 100 автомобилей, а детектор нашел 80, recall равен 0,8, или 80%.
Precision и recall оценивают вместе. Высокий precision при низком recall означает, что модель редко срабатывает ошибочно, но пропускает часть объектов. При низком precision и высоком recall модель находит большую часть объектов, но чаще принимает за них что-то другое.
IoU (степень совпадения рамок) показывает, насколько рамка модели совпадает с рамкой из разметки. Значение меняется от 0 до 1: при 0 рамки не пересекаются, при 1 — совпадают полностью. Например, порог IoU 0,5 означает, что для оценки предсказание засчитывают только при IoU не ниже 0,5.
AP (качество детекции одного класса) рассчитывают для отдельного класса, например автомобилей, на основе precision и recall при разных порогах confidence. Так можно оценить модель не при одном выбранном пороге, а при разных уровнях уверенности в предсказаниях.
mAP (качество детекции по всем классам) получают, усредняя AP для всех классов в датасете. При расчете также задают порог IoU — насколько точно рамка модели должна совпасть с рамкой из разметки. Поэтому рядом с mAP обычно указывают этот порог: например, mAP@0.5 рассчитывают при IoU 0,5.
Более строгий вариант — mAP@0.5:0.95. В этом случае результат рассчитывают при нескольких порогах IoU от 0,5 до 0,95 и усредняют. Чем выше порог, тем точнее предсказанная рамка должна совпадать с разметкой.
При сравнении моделей важно использовать одинаковые условия оценки: один датасет и одинаковые пороги IoU.
Как оценить скорость YOLO
Алгоритм YOLO часто используют для обработки видеопотока в реальном времени. Скорость такой системы оценивают по FPS и задержке. FPS показывает, сколько кадров система обрабатывает за секунду, а задержка — сколько времени проходит от получения кадра до готового результата. При этом высокий FPS не всегда означает низкую задержку.
На эти показатели влияет не только время инференса. Общая задержка складывается из чтения и декодирования видео, изменения размера кадра, передачи данных на ускоритель, самого инференса, постобработки и передачи результата приложению.
Выбор оборудования зависит от модели и требований к скорости. GPU позволяет выполнять много вычислений параллельно, поэтому его часто используют для крупных моделей и изображений высокого разрешения. Компактные модели при небольшой нагрузке можно запускать на CPU. Если видео нужно обрабатывать непосредственно рядом с камерой, используют edge-устройства, но их возможности обычно ограничены доступной памятью и вычислительной мощностью.
Скорость проверяют на том оборудовании, с тем разрешением изображения и в том формате модели, которые будут использоваться после запуска. При тестировании отдельно измеряют время подготовки данных, инференса и постобработки. Это помогает найти источник задержки: например, им может оказаться не сама модель, а декодирование видео или передача данных между CPU и GPU.
Как выбрать модель и проверить ее на пилоте
Определите требования к системе. Зафиксируйте, какие классы нужно распознавать, какие ошибки критичны и с какой задержкой должен работать детектор. Используйте измеримые критерии: например, минимальный recall для критичного класса, допустимое число ложных срабатываний и максимальную задержку обработки кадра.
Начните с компактной модели. Возьмите вариант n или s как базовый и сравните его с m, l или x, если качества не хватает. Более крупные модели могут повысить качество детекции, но требуют больше памяти и вычислительных ресурсов.
Сравнивайте модели в одинаковых условиях. Используйте одну тестовую выборку, одинаковое разрешение и одно оборудование. Для каждой конфигурации измерьте mAP, precision и recall по нужным классам, задержку и потребление памяти. Если более крупная модель дает лучший mAP, но не укладывается в требования по задержке или памяти, проверьте более компактный вариант.
Проверяйте модель на данных с реальной точки установки. Добавьте в выборку разные условия, которые встретятся после запуска: дневные и ночные кадры, разные ракурсы, перекрытия объектов, часы пик и пустые сцены.
Разделите данные для обучения, валидации и тестирования. По валидационной выборке подбирайте confidence и другие параметры. Тестовую выборку оставьте для итоговой проверки, чтобы оценить модель на данных, которые не использовались при настройке.
Измерьте скорость всего видеоконвейера. Учитывайте декодирование и подготовку кадра, инференс, NMS и другую постобработку, а также логику приложения. Проводите тест на том GPU, CPU или edge-устройстве, которое планируете использовать после запуска.
Заранее задайте критерии успешного пилота. Зафиксируйте минимально допустимое качество по целевым классам, предел для ложных срабатываний и максимальную задержку. По итогам пилота сравните эти значения с результатами каждой конфигурации.
Если компактная модель уже выполняет требования пилота, переход на более крупную стоит проверять по конкретному выигрышу. Например, насколько вырос recall для критичного класса и какой ценой — сколько добавилось задержки и потребления памяти. Небольшой прирост mAP сам по себе не всегда оправдывает более тяжелую модель.
Почему YOLO ошибается при распознавании объектов
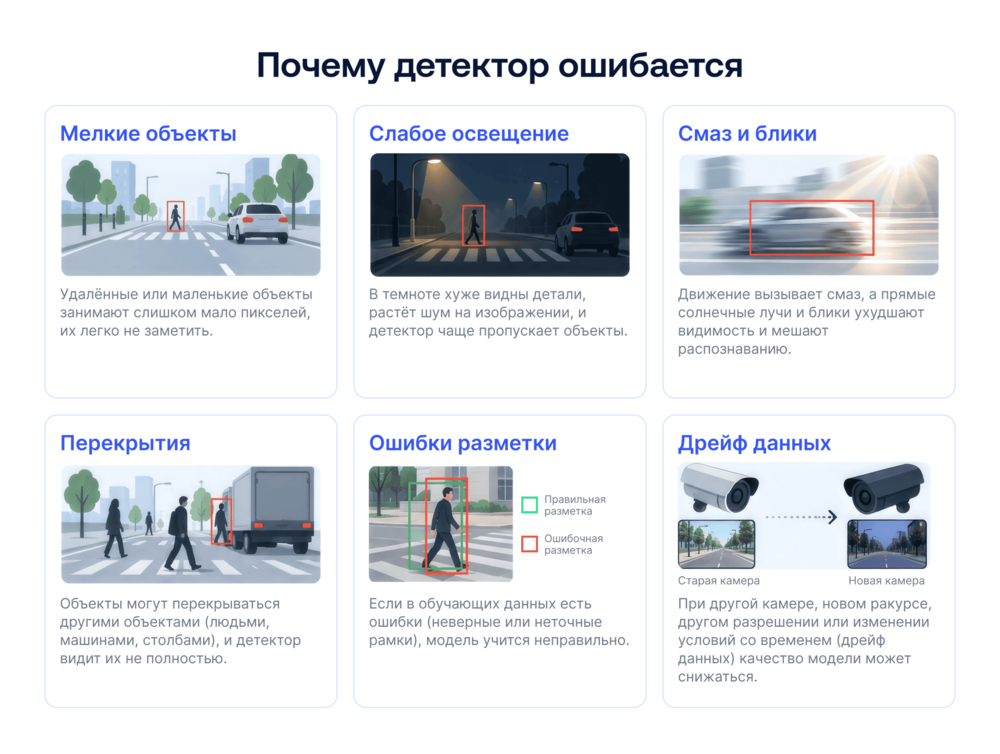
Качество распознавания объектов нейросетью зависит не только от выбранной модели. Детектор может пропускать нужные объекты, путать классы или находить объекты там, где их нет. Причину ошибки стоит искать в данных, условиях съемки и настройках модели.
Чаще всего проблемы возникают в нескольких случаях:
- Объект слишком маленький или находится далеко. При уменьшении изображения небольшой объект может занимать всего несколько пикселей, и модели становится сложнее выделить его признаки. В таком случае проверяют работу с большим входным разрешением, меняют положение камеры или добавляют в датасет больше примеров мелких объектов. Для небольших объектов также применяют разбиение крупных изображений на фрагменты, чтобы сохранить больше деталей.
- Изображение отличается от обучающих данных. Смаз, блики, тени, слабое освещение, другой ракурс или фон могут снизить качество детекции. Такие условия нужно включать в обучающую и тестовую выборки, а не проверять модель только на хорошо снятых кадрах.
- Объекты перекрывают друг друга. Если люди, автомобили или товары часто частично закрыты другими объектами, такие примеры должны встречаться в датасете. Иначе модель может пропускать их или неточно определять рамки.
- Одних классов в датасете значительно меньше, чем других. Модель может хорошо распознавать частые классы и хуже — редкие. Поэтому precision, recall и AP стоит смотреть не только в среднем, но и отдельно для каждого класса.
- В разметке есть ошибки. Пропущенные объекты, перепутанные классы и неточные рамки дают модели неверные примеры. Важно и единообразие: одинаковые ситуации должны размечаться по одним правилам.
- Не хватает примеров без целевых объектов. Если модель часто видит объекты там, где их нет, в датасет можно добавить фоновые изображения без целевых классов. Они помогают обучить детектор отличать объект от похожих элементов фона и снижать число ложных срабатываний.
- После запуска изменились условия съемки. Замена камеры может изменить разрешение, объектив, угол обзора, высоту установки, цветопередачу или уровень шума. На результат также влияют новый фон, сезон, освещение, форма сотрудников или упаковка товара. Если реальные данные начинают отличаться от обучающих, возникает дрейф данных и качество модели может снижаться.
После запуска стоит сохранять кадры с ошибками и разделять их хотя бы на две группы: пропущенные объекты и ложные срабатывания. Затем можно проверить, повторяются ли ошибки в определенных условиях, у конкретного класса или камеры. Это помогает понять, что менять: датасет, разметку, пороги confidence и NMS, разрешение изображения или саму модель.
На пилоте модель лучше проверять на непрерывных фрагментах видео с реальных камер. На отдельных кадрах детекция может работать стабильно, а в видеопотоке объект — пропадать на соседних кадрах или определяться как разные классы. Такие ошибки по набору отдельных изображений можно не заметить.
Что контролировать после запуска
После запуска условия работы модели могут измениться: камеру могут сместить или заменить, меняются освещение, фон, ассортимент товаров и внешний вид объектов. Поэтому качество детекции нужно периодически проверять на контрольной выборке и на новых данных из реального видеопотока.
Отслеживайте не только mAP, precision и recall, но и показатели, связанные с задачей системы: число ложных тревог, пропуски критичных объектов, количество ручных исправлений. Резкое изменение этих показателей помогает заметить проблему, даже если агрегированные метрики меняются незначительно.
Сохраняйте примеры ошибок и периодически пересматривайте их. Если модель начинает хуже работать в определенных условиях — например, после замены камеры или появления нового типа упаковки, — такие данные можно разметить и добавить в датасет для следующего обучения.
Итоги
Не оценивайте YOLO только по скорости или качеству модели на тестовом датасете. Проверяйте всю систему в условиях, близких к реальным: от исходного видеопотока и качества детекции до задержки на целевом оборудовании.
Учитывайте данные не меньше, чем архитектуру модели. Качество разметки, разнообразие датасета и соответствие обучающих данных реальным условиям напрямую влияют на результат. Выбирайте конфигурацию, которая выполняет требования конкретной задачи по качеству и скорости, а не просто показывает лучшие отдельные метрики.
Вопросы и ответы
Какие типы изображений и видео можно подавать на вход YOLO?
YOLO может обрабатывать отдельные изображения, видеофайлы, поток с камеры и сетевой видеопоток. Доступные источники зависят от конкретной реализации и способа интеграции.
Может ли YOLO находить несколько классов объектов в одном кадре?
Да. Если модель обучена распознавать несколько классов, в одном кадре она может обнаружить объекты разных категорий и вернуть для каждого класс, рамку и confidence.
Умеет ли YOLO отслеживать объект между кадрами без отдельного трекера?
Нет. Детекция сама по себе не сохраняет идентификатор объекта между кадрами. Для отслеживания используют трекеры, например BoT-SORT или ByteTrack. В некоторых библиотеках трекинг доступен вместе с YOLO через общий API.
Сколько размеченных примеров нужно для дообучения модели?
Универсального числа нет: оно зависит от количества классов, разнообразия условий съемки и сложности объектов. Для пилота важнее собрать примеры основных рабочих сценариев и отдельно проверить модель на данных, которые не использовались при обучении.
Как размечать частично закрытые и мелкие объекты?
Заранее задайте единые правила для частично закрытых и мелких объектов. Определите, при какой степени перекрытия объект еще размечают и какие мелкие объекты относятся к целевым для вашей задачи. Применяйте эти правила ко всему датасету, чтобы одинаковые случаи не размечались по-разному.
Чем порог confidence отличается от NMS?
Порог confidence задает минимальную уверенность, при которой предсказание сохраняют. NMS решает другую задачу — удаляет дублирующиеся рамки одного объекта. В end-to-end моделях отдельный этап NMS может не использоваться.
Почему качество модели падает на видео с новой камеры?
Новая камера может отличаться разрешением, объективом, углом обзора, цветопередачей, уровнем шума и настройками сжатия. Из-за этого изображения отличаются от тех, на которых модель обучалась, даже если сама сцена почти не изменилась.
Можно ли запускать YOLO на CPU или edge-устройстве?
Да. На CPU и edge-устройствах можно запускать компактные модели, если их скорость и потребление памяти соответствуют требованиям проекта. Производительность проверяйте на конкретном устройстве и с тем разрешением изображения, которое будет использоваться после запуска.
Как обнаружить деградацию модели после внедрения?
Следите за пропусками объектов, ложными срабатываниями, ручными исправлениями и метриками на контрольной выборке. Если показатели стабильно ухудшаются, проверьте, не изменились ли входные данные: камера, освещение, фон или сами объекты.
От чего зависит выбор конкретной версии и размера модели YOLO?
Учитывайте качество детекции, задержку, потребление памяти, целевое оборудование, доступные форматы экспорта и лицензию. Сравнивайте подходящие варианты на одном датасете и оборудовании, которое планируете использовать после запуска.