

Когда на сервере нужно быстро найти ошибку в журнале, проверить значение в конфигурации или отфильтровать длинный вывод другой программы, обычно открывают терминал и используют grep. Инструмент работает построчно: сопоставляет текст с заданным шаблоном и выводит совпадения. Одна короткая команда заменяет ручной просмотр сотен записей.
Команда grep в Linux полезна администраторам, разработчикам, инженерам DevOps и специалистам поддержки. Разберем синтаксис, основные параметры, регулярные выражения, конвейеры и причины неожиданных результатов.
Как работает текстовый фильтр
grep читает файлы или стандартный ввод и выбирает строки, соответствующие шаблону. По умолчанию он трактуется как базовое регулярное выражение, но можно искать и обычное слово.
|
1 |
grep 'error' app.log |
Команда выведет строки app.log с последовательностью error и не изменит исходный файл. Результат можно перенаправить или передать по конвейеру другой команде.
Утилита поиска grep особенно удобна в трех ситуациях:
- анализ журналов приложений и операционной системы;
- проверка конфигурационных файлов;
- фильтрация вывода ps, journalctl, systemctl, ip и других команд.
Базовая схема вызова
Общий синтаксис выглядит так:
|
1 |
grep [параметры] 'шаблон' файл |
Параметры меняют поведение программы, шаблон задает условие, а последний аргумент указывает файл или каталог. Без имени файла grep читает стандартный ввод. В конвейере grep — команда-фильтр, которую удобно ставить после вертикальной черты:
|
1 |
команда | grep [параметры] 'шаблон' |
Например, следующий конвейер оставит только процессы, в строках которых есть nginx:
|
1 |
ps aux | grep '[n]ginx' |
Форма '[n]ginx' помогает исключить из результата сам процесс grep. Для поиска идентификаторов процессов лучше подойдет pgrep.
Шаблоны лучше заключать в одинарные кавычки, чтобы оболочка не обработала *, $, [ и другие символы. Двойные кавычки нужны для подстановки переменной:
|
1 2 |
service='nginx' grep "$service" services.txt |
Параметры, которые нужны чаще всего
Для ежедневной работы достаточно небольшого набора опций.
-i, --ignore-case — искать без учета регистра. Команда найдет error, Error и ERROR:
|
1 |
grep -i 'error' app.log |
-n, --line-number — показывать номер найденной строки:
|
1 |
grep -n 'timeout' app.log |
-v, --invert-match — выводить строки, которые не соответствуют шаблону:
|
1 |
grep -v '^#' app.conf |
-w, --word-regexp — искать отдельное слово, а не часть другого слова:
|
1 |
grep -w 'port' app.conf |
-x, --line-regexp — выбирать только строки, целиком совпадающие с выражением:
|
1 |
grep -x 'enabled' flags.txt |
-F, --fixed-strings — воспринимать шаблон как обычный текст. Это полезно, если в нем есть точки, квадратные скобки или другие символы regex:
|
1 |
grep -F 'user[id]' app.log |
-E, --extended-regexp — включать расширенные регулярные выражения. Они позволяют удобно использовать альтернативы, группировку и интервалы:
|
1 |
grep -E 'error|warning|critical' app.log |
-o, --only-matching — выводить не всю строку, а только найденный фрагмент:
|
1 |
grep -oE '[0-9]{3}' access.log |
-c, --count — считать подходящие строки. Важно: опция считает строки с совпадением, а не общее количество всех вхождений:
|
1 |
grep -c 'ERROR' app.log |
-l, --files-with-matches — показывать только имена файлов, где найден шаблон:
|
1 |
grep -l 'listen 443' /etc/nginx/*.conf |
-q, --quiet — не печатать результат, а вернуть только код завершения. Такой режим удобен в скриптах:
|
1 2 3 |
if grep -q 'ready'if grep -q 'ready' status.txt; then echo 'Сервис готов' fi |
-A, -B и -C выводят контекст после, до или с обеих сторон найденной строки:
|
1 |
grep -C 3 'Exception' app.log |
Комментарий эксперта. Начинающие пользователи часто забывают кавычки вокруг шаблона и путаются в регулярных выражениях. Еще одна типичная ошибка — запуск рекурсивного поиска по слишком большому каталогу без фильтрации файлов.
Примеры для повседневной работы
Чтобы понять, что делает команда grep, удобнее рассмотреть небольшие задачи.
Найти сообщения об ошибках без учета регистра:
|
1 |
grep -in 'error' /var/log/myapp/app.log |
Показать строки, где есть ERROR или WARN:
|
1 |
grep -En 'ERROR|WARN' app.log |
Исключить комментарии и пустые строки из конфигурации:
|
1 |
grep -Ev '^[[:space:]]*(#|$)' app.conf |
Найти точный IP-адрес как обычный текст:
|
1 |
grep -F '192.168.10.25' access.log |
Показать только IPv4-подобные фрагменты:
|
1 |
grep -oE '([0-9]{1,3}\.){3}[0-9]{1,3}' access.log |
Шаблон проверяет форму записи, но не валидирует диапазон каждого октета.
Посчитать строки со статусом 500:
|
1 |
grep -c ' 500 ' access.log |
Следить за новым выводом журнала и оставлять только ошибки:
|
1 |
tail -F app.log | grep --line-buffered -i 'error' |
--line-buffered сразу передает найденные строки дальше по конвейеру, что удобно для потоковых логов.
Такие команды обычно выполняют на Linux-серверах, где поиск по журналам и конфигурациям является ежедневной задачей администратора. Для тестового стенда или рабочего окружения подойдут облачные серверы Рег.облака: grep входит в стандартный набор инструментов большинства дистрибутивов.
Поиск в наборах файлов и каталогах
Несколько файлов можно перечислить через пробел:
|
1 |
grep -n 'database' app.conf worker.conf api.conf |
Оболочка также умеет раскрывать маски:
|
1 |
grep -n 'ERROR' /var/log/myapp/*.log |
Для обхода каталога используют -r:
|
1 |
grep -rn 'listen' /etc/nginx/ |
Опция -R также следует по символическим ссылкам, поэтому область обхода может неожиданно расшириться. Обычно безопаснее -r.
При большом количестве файлов лучше сразу ограничить выборку:
|
1 2 3 |
grep -rn --include='*.conf' 'timeout' /etc/ grep -rn --exclude='*.gz' 'ERROR' /var/log/ grep -rn --exclude-dir='.git' 'api_key' ~/project/ |
Для вывода только имен подходящих файлов применяют сочетание -rl, а для списка файлов без совпадений — -rL:
|
1 2 |
grep -rl 'deprecated_option' /etc/myapp/ grep -rL 'managed=true' ./configs/ |
Параметр -s скрывает сообщения о недоступных файлах, но не дает дополнительных прав. Для чтения защищенных данных может потребоваться sudo.
При рекурсивном поиске по каталогам с большими логами важно учитывать объем данных и доступное дисковое пространство. Для архивного хранения журналов можно использовать объектное S3-хранилище Рег.облака: оно позволяет хранить большие объемы данных с репликацией для защиты от сбоев. Нужные логи при необходимости можно скачать на сервер и проанализировать с помощью grep
-r.
Шаблоны вместо буквального текста
Регулярное выражение описывает общий шаблон. По умолчанию grep использует BRE, с -E включается ERE. В GNU grep может быть режим -P для Perl-совместимых выражений, но он не относится к переносимому POSIX-набору.
Основные элементы:
^обозначает начало строки;$обозначает конец строки;.соответствует одному произвольному символу;[abc]соответствует одному символу из набора;[^abc]исключает перечисленные символы;*означает ноль или больше повторений предыдущего элемента;[[:digit:]]обозначает цифру,[[:space:]]— пробельный символ;- в режиме
-Eоператоры+, ?, |, (), {n,m}записываются без дополнительного экранирования.
Примеры:
Найти строки, которые начинаются со слова server:
|
1 |
grep '^server' nginx.conf |
Найти строки, которые заканчиваются точкой с запятой:
|
1 |
grep ';$' settings.conf |
Найти строки, начинающиеся с даты в формате YYYY-MM-DD:
|
1 |
grep -E '^[[:digit:]]{4}-[[:digit:]]{2}-[[:digit:]]{2}' app.log |
Найти имена файлов с расширением jpg, png или webp:
|
1 |
grep -E '\.(jpg|png|webp)$' files.txt |
Для буквального текста надежнее -F: grep -F 'a+b' file.txt ищет именно последовательность a+b.
Комментарий эксперта. Регулярные выражения нужны, когда пользователь ищет не конкретное слово, а общий шаблон: дату, код ошибки, IP-адрес или несколько допустимых вариантов написания. Для обычной строки лучше не усложнять запрос и применять -F.
Работа в конвейерах
grep принимает стандартный вывод другой программы, поэтому из команд можно собирать короткие цепочки.
Проверить состояние служб с ошибкой:
|
1 |
systemctl --failed --no-pager | grep -v '^$' |
Найти события SSH в журнале systemd:
|
1 2 |
journalctl -u ssh --since today --no-pager | grep -Ei 'failed|invalid|accepted' |
Отобрать прослушиваемые порты:
|
1 |
ss -lntp | grep 'LISTEN' |
Проверить переменные окружения с определенным префиксом:
|
1 |
printenv | grep '^APP_' |
Найти заполнение диска выше условного порога с дальнейшей обработкой:
|
1 |
df -h | awk 'NR > 1 {print $5, $6}' | grep -E '^[89][0-9]%|^100%' |
Иногда grep не нужен: awk умеет фильтровать строки, а journalctl имеет собственные параметры отбора. Цепочка должна оставаться понятной.
При разборе серверных журналов grep помогает за секунды найти ошибки, предупреждения и события по ключевым словам. Чаще всего его комбинируют с journalctl, systemctl, ps, find и awk.
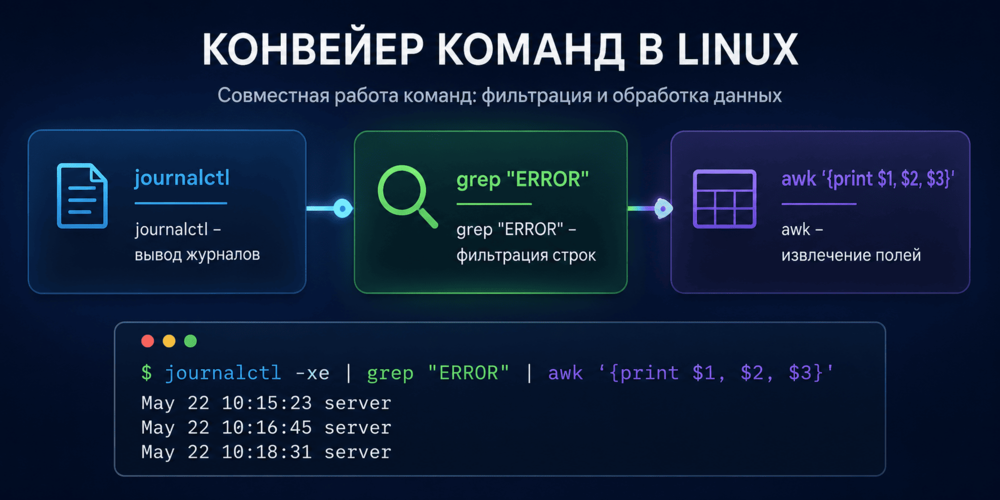
grep в конвейерах — основа мониторинга и диагностики. Чтобы автоматизировать сбор и обработку логов, можно использовать low-code-инструмент n8n от Рег.облака. Например, grep находит ошибки, а n8n отправляет уведомление в Telegram или запускает сценарий восстановления сервиса. Готовый образ с n8n разворачивается за несколько минут.
Совместная работа с find
grep ищет внутри текста, а find отбирает файлы по имени, типу, времени или размеру. Их объединяют, когда сначала нужен точный список файлов.
Безопасный вариант с -exec:
|
1 |
find /etc/myapp -type f -name '*.conf' -exec grep -nH 'timeout' {} + |
Знак + передает сразу группу файлов, а -H заставляет печатать имя файла.
Для имен с пробелами и переводами строк можно использовать нулевые разделители:
|
1 |
find ./logs -type f -name '*.log' -print0 | xargs -0 grep -nH 'ERROR' |
Часто достаточно grep -r с --include. find нужен при отборе по возрасту или размеру:
|
1 |
find /var/log -type f -mtime -1 -size +1M -exec grep -nH 'timeout' {} + |
Почему результат бывает пустым
Если видимая строка не находится, причина часто не в grep.
Проверьте следующее:
- Регистр символов. Для нечувствительного поиска добавьте
-i. - Кавычки и экранирование. Оболочка могла обработать
$, *, [или обратную косую черту раньше grep. - Режим шаблона. Для буквального текста используйте
-F, для расширенного regex —-E. - Кодировку. Файл может быть записан не в UTF-8 или содержать несовместимые символы.
- Окончания строк. В файлах из Windows могут присутствовать CRLF и невидимый символ
\r. - Двоичный формат или сжатие. Обычный grep не распаковывает архивы автоматически. Для gzip-файлов применяют zgrep.
- Область поиска. Маска,
--include,--excludeили права доступа могли исключить нужный файл. - Границы слова. Опция
-wзависит от того, какие символы считаются буквами, цифрами и знаком подчеркивания.
Невидимые символы можно увидеть так:
|
1 |
sed -n '1,20l' file.txt |
Для проверки кода завершения выполните:
|
1 2 |
grep 'pattern' file.txt >/dev/null echo $? |
Код 0 означает совпадение, 1 — его отсутствие, 2 — ошибку.
Перед усложнением шаблона стоит проверить данные: регистр, кодировку, кавычки, окончание строк и фактический путь. Очень часто проблема связана с оболочкой или форматом файла, а не с grep.
Неудачные приемы и способы их исправить
Первая ошибка — поиск по всему корню без ограничений:
|
1 |
grep -r 'token' / |
Она обходит огромную область, поэтому лучше указать рабочий каталог и исключения.
Вторая ошибка — лишнее использование cat:
|
1 |
cat app.log | grep 'ERROR' |
Короче написать grep 'ERROR' app.log. cat нужен, когда действительно объединяет потоки.
Третья ошибка — попытка обработать имена файлов обычным текстовым разделителем. Конструкции с find и xargs без -print0/-0 могут сломаться на пробелах. Альтернатива — find -exec ... {} +.
Четвертая ошибка — пытаться разбирать сложные JSON, YAML или XML с помощью grep. Для структурированных данных надежнее jq, yq или XML-инструмент.
Пятая ошибка — ожидать, что -c посчитает все совпадения. Этот параметр считает подходящие строки. Количество отдельных фрагментов можно получить, например, так:
|
1 |
grep -o 'ERROR' app.log | wc -l |
Инструменты с похожими задачами
Эти инструменты пересекаются, но решают разные задачи.
grep выбирает строки по текстовому шаблону. Это стандартный, распространенный и удобный инструмент для файлов, логов и конвейеров.
find ищет файлы и каталоги по метаданным: имени, типу, размеру, владельцу или времени изменения. Содержимое он обычно передает другой команде.
awk обрабатывает строки как записи и поля. Его выбирают, когда нужно не только найти строку, но и выделить столбец, выполнить вычисление, сгруппировать или переформатировать данные.
sed предназначен для потокового редактирования: замены, удаления, вставки и выборочной печати строк. Для простой фильтрации он способен заменить grep, но часто такая запись менее очевидна.
ripgrep, команда rg, ориентирован на быстрый рекурсивный поиск в репозиториях. По умолчанию он учитывает .gitignore и пропускает скрытые и двоичные файлы. grep чаще доступен без установки и подходит для системных скриптов.
Для больших репозиториев исходного кода часто удобнее ripgrep: он быстро обходит каталог и учитывает ignore-файлы. grep остается отличным выбором для серверных логов, стандартных конвейеров и систем, где нельзя рассчитывать на дополнительное ПО.
Для тестирования команд, скриптов и кода в среде, приближенной к рабочей, можно использовать Free Tier от Рег.облака - бесплатный облачный сервер с полноценным root-доступом и возможностью бесшовно перейти на коммерческую инфраструктуру.
Краткий итог
grep умеет учитывать регистр, показывать номера строк, искать рекурсивно, применять regex и работать в конвейерах. Для старта достаточно -i, -n, -v, -r, -F и -E.
Комментарий эксперта. Новичку не нужно запоминать десятки ключей. Полезнее уверенно освоить несколько основных параметров, привыкнуть заключать шаблоны в кавычки и проверять команду на небольшом наборе данных.
Вопросы и ответы
Что делает команда grep в Linux?
Она читает текст из файлов или стандартного ввода, сопоставляет строки с заданным шаблоном и выводит подходящие строки.
Как искать текст сразу в нескольких файлах?
Перечислите файлы через пробел или используйте маску: grep -n 'error' app1.log app2.log либо grep -n 'error' *.log.
Чем отличается grep от egrep и fgrep?
Исторически egrep соответствует grep -E, а fgrep — grep -F. В современных командах лучше использовать явные опции -E и -F, поскольку отдельные имена egrep и fgrep считаются устаревшими.
Как выполнить поиск без учета регистра?
Добавьте параметр -i: grep -i 'error' app.log.
Как искать с использованием регулярных выражений?
Базовые выражения работают по умолчанию. Для расширенного синтаксиса используйте grep -E 'error|warning' app.log.
Как вывести номера найденных строк?
Примените -n: grep -n 'timeout' app.log.
Как рекурсивно искать текст во всей директории?
Используйте grep -r 'шаблон' /путь/к/каталогу. При необходимости ограничьте файлы через --include и исключите каталоги через --exclude-dir.
Когда лучше использовать ripgrep вместо grep?
При поиске по большому проекту или репозиторию, где важны скорость, рекурсивный обход и автоматический учет .gitignore.
Можно ли использовать grep вместе с find?
Да. Например: find . -type f -name '*.conf' -exec grep -nH 'timeout' {} +.
Почему grep ничего не находит, хотя строка существует?
Проверьте регистр, кавычки, режим -F или -E, кодировку, окончания строк, права доступа и то, попал ли файл в выбранную область поиска.









В рабочей практике Linux-администратора grep используется почти ежедневно. Самые частые задачи — поиск ошибок в логах, проверка параметров конфигурации и фильтрация вывода других команд через конвейеры.