

Если модели не хватает видеопамяти или обучение на одной GPU занимает слишком много времени, можно распределить работу между несколькими GPU. В статье разберем основные подходы и покажем, что важно учесть ML-инженерам и разработчикам при обучении моделей.
Что такое Multi-GPU и для каких задач его используют
Multi-GPU — это режим, в котором одну задачу выполняют несколько видеокарт. При обучении моделей его используют в двух основных случаях: чтобы сократить время обучения или запустить модель, которой не хватает памяти одной GPU.
Нагрузка между видеокартами распределяется по-разному: они могут параллельно обрабатывать разные части данных или хранить и вычислять разные части модели. В серверных и облачных средах это также позволяет подбирать нужное количество GPU под конкретную задачу.
Почему обучение моделей упирается в вычисления и видеопамять
Во время обучения нейросеть обрабатывает данные, считает ошибку, вычисляет градиент и обновляет каждый параметр модели. С ростом числа слоев и параметров увеличивается объем вычислений на каждом шаге. Дополнительную нагрузку создают крупные батчи и длинные входные последовательности.
VRAM расходуется не только на параметры модели. В памяти также находятся градиенты, активации — промежуточные результаты вычислений — и состояния оптимизатора. Поэтому модель, которая помещается на GPU при обычном запуске, во время обучения может потребовать заметно больше памяти.
Как несколько GPU ускоряют обучение нейросети
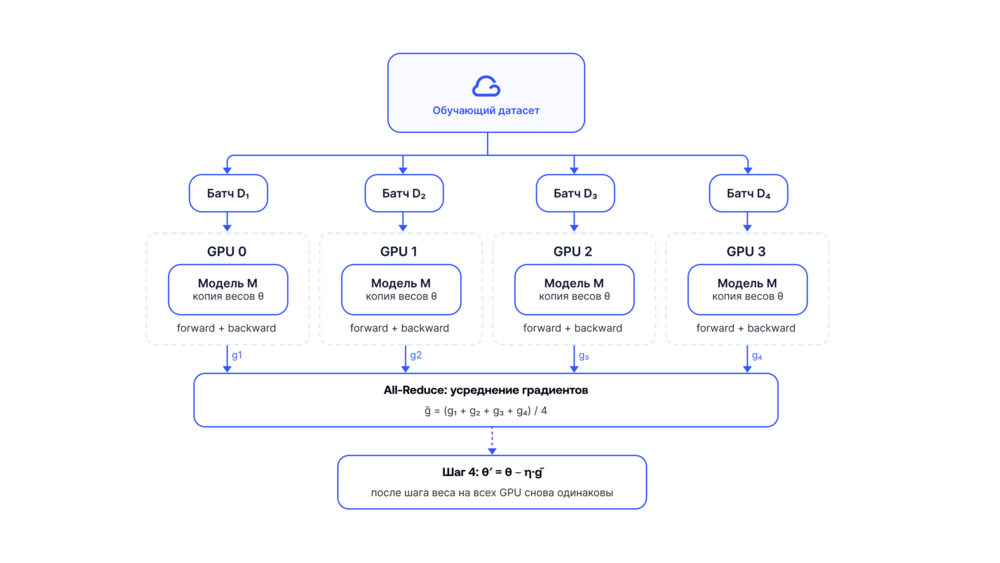
Если основная проблема в скорости, часть вычислений можно выполнять параллельно. Например, батч делят между несколькими GPU: каждая видеокарта обрабатывает свою часть данных, независимо считает градиенты, а затем результаты синхронизируются перед обновлением параметров модели.
За то же время система успевает обработать больше примеров или токенов, поэтому растет производительность. Реальный прирост зависит от соотношения вычислений и обмена между картами. Если коммуникация занимает заметную часть шага, добавление новых GPU дает все меньший прирост.
Когда Multi-GPU нужен из-за скорости, а когда — из-за нехватки VRAM
Причина перехода на несколько GPU определяет способ распределения нагрузки. Если модель помещается на одну карту, но обучение идет слишком долго, чаще используют Data Parallelism: на каждой GPU находится копия модели, а данные делятся между ускорителями.
Переход на Multi-GPU оправдан, когда одна карта уже ограничивает задачу по времени обучения или объему VRAM. Если модель небольшая, а значительная часть шага уходит на обмен данными, дополнительные GPU могут почти не ускорить обучение.
С нехваткой VRAM ситуация другая. Просто добавить ещё пару видеокарт недостаточно — их память не объединяется в общий пул. Чтобы задействовать несколько GPU, нужно разбить модель: распределить между картами параметры, градиенты или состояния оптимизатора. FSDP шардирует параметры, градиенты и состояния оптимизатора, а Tensor Parallelism и Pipeline Parallelism распределяют между GPU части самой модели.
Если модель помещается на одну GPU, но обучение занимает слишком много времени, обычно начинают с Data Parallelism. Если не помещается сама модель или не хватает памяти под градиенты и состояния оптимизатора, смотрят в сторону FSDP, Tensor или Pipeline Parallelism. Для крупных моделей эти подходы можно сочетать.
Параллелизм данных: как работает Data Parallelism
Data Parallelism используют, когда модель помещается в память одной GPU, но обучение нужно ускорить. В этом случае на каждой видеокарте хранится одинаковая копия модели, а батч делится между GPU. Если батч содержит 256 примеров и в сервере четыре GPU, каждая карта может обработать по 64 примера.
Каждая GPU считает градиенты на своей части данных, затем они синхронизируются, чтобы все копии модели обновились одинаково. Скорость растет за счет параллельной обработки, но расход памяти на саму модель почти не уменьшается: ее полная копия все равно нужна на каждом устройстве.
Параллелизм модели, Tensor Parallelism и Pipeline Parallelism
Если модель не помещается на одну видеокарту, делить только данные уже недостаточно. Тогда между GPU распределяют саму модель. Для этого используют несколько схем:
Tensor Parallelism
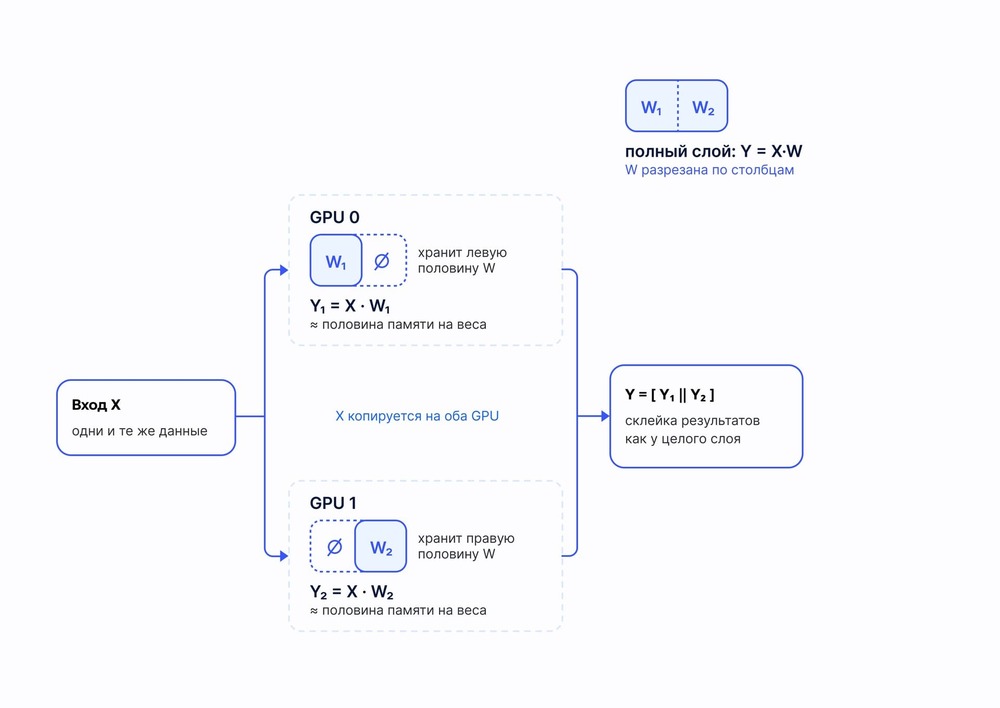
Tensor Parallelism делит вычисления внутри одного слоя. Большую матрицу параметров можно разбить между несколькими GPU: каждая карта хранит свой фрагмент и считает свою часть операции, после чего результаты объединяются.
Так можно работать со слоями, которые слишком велики для одной GPU. Обмен между картами происходит часто, поэтому производительность сильно зависит от скорости межсоединения.
Pipeline Parallelism
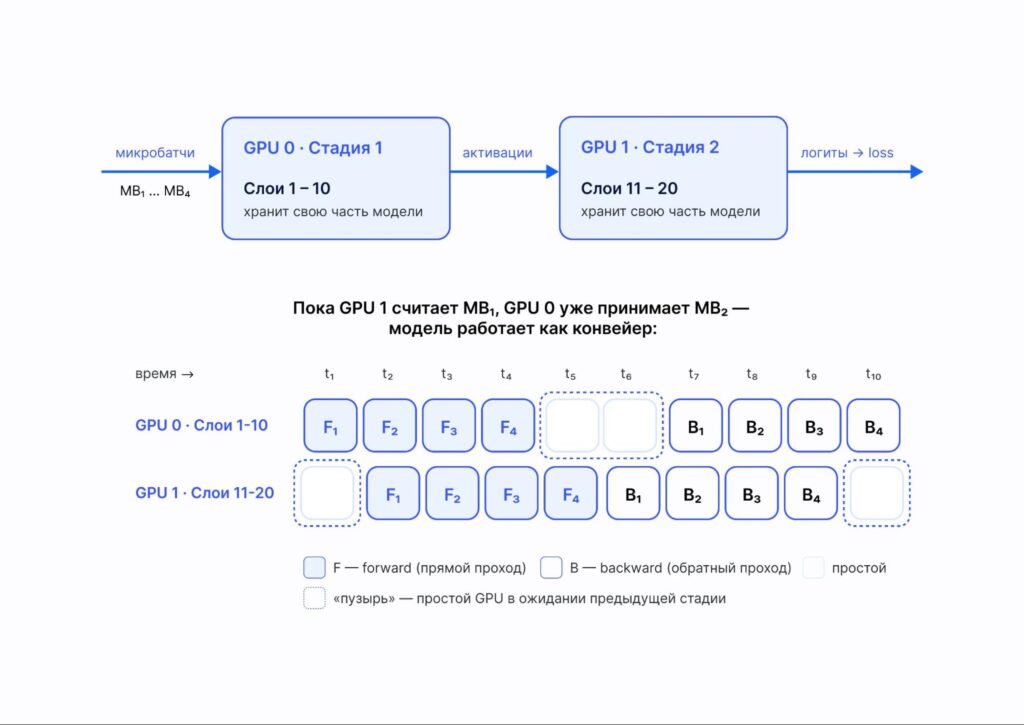
Pipeline Parallelism распределяет по GPU последовательные группы слоев. Например, первые слои работают на одной карте, следующие — на второй и так далее. Батч делят на микробатчи, чтобы разные этапы модели могли работать одновременно, а карты меньше простаивали.
Pipeline Parallelism подходит для моделей, которые удобно разделить на последовательные этапы. Tensor Parallelism используют, когда вычисления внутри отдельных слоев можно эффективно распределить между несколькими GPU. Какой вариант будет лучше, зависит от архитектуры модели, характера вычислений и объема обмена данными между видеокартами. В крупных моделях эти методы часто комбинируют: Pipeline Parallelism делит модель на этапы, а Tensor Parallelism распределяет вычисления внутри них.
Синхронизация градиентов и обмен данными между GPU
Несколько GPU работают параллельно, но полностью независимо друг от друга обучать одну модель они не могут. Им приходится регулярно обмениваться результатами вычислений.
В Data Parallelism каждая видеокарта рассчитывает градиенты на своей части батча. Перед обновлением параметров эти градиенты нужно объединить, чтобы на всех GPU сохранилась одинаковая версия модели. В PyTorch DDP для этого используется All-Reduce: карты обмениваются градиентами и получают одинаковый итоговый результат. Часть обмена выполняется одновременно с обратным проходом, что сокращает время ожидания.
В других видах параллелизма передаются уже другие данные. Tensor Parallelism обменивается промежуточными результатами внутри слоев, Pipeline Parallelism передает активации от одного этапа модели к следующему, а FSDP собирает распределенные параметры перед вычислениями. Чем чаще происходят такие передачи и чем они объемнее, тем больше времени GPU тратят не на вычисления, а на коммуникацию.
PCIe, NVLink и NVSwitch: почему межсоединение влияет на масштабирование
Скорость обмена зависит от того, как GPU соединены внутри сервера. Если канал не успевает передавать данные, часть карт простаивает и эффективность новых ускорителей снижается. Поэтому значение имеет не только пропускная способность соединений, но и их топология — схема связей между видеокартами.
Обмен данными между GPU организуют с помощью нескольких технологий.
PCIe — стандартная шина, через которую GPU подключаются к процессору и другим компонентам сервера. Её также можно использовать для обмена между видеокартами.
NVLink — высокоскоростное соединение NVIDIA, которое обеспечивает более быстрый обмен данными между GPU, чем PCIe в типичных серверных конфигурациях.
NVSwitch — коммутатор, который соединяет несколько GPU через NVLink и позволяет организовать высокоскоростной обмен между ними.
Наличие NVLink еще не означает, что все видеокарты соединены напрямую или могут обмениваться данными с одинаковой скоростью. Например, в сервере с восемью GPU соединения NVLink могут связывать только отдельные пары. Внутри каждой пары данные передаются быстро, а обмен между парами проходит через PCIe. Если Tensor Parallelism использует все восемь карт, медленные соединения будут ограничивать производительность.
Системы с NVSwitch позволяют организовать высокоскоростную связь между всеми GPU. Однако при аренде сервера важно уточнять не только наличие NVLink и NVSwitch, но и доступную топологию, включая возможные ограничения виртуализации.
В крупных GPU-кластерах данные передаются еще и между серверами. Скорость межсерверной сети также влияет на масштабирование, поэтому конфигурацию соединений нужно подбирать с учетом выбранного способа параллелизма и интенсивности обмена данными.
Какое ПО используют для Multi-GPU: PyTorch DDP, FSDP, DeepSpeed и Accelerate
Сам по себе сервер с несколькими GPU не распределяет обучение между ними. Этим занимается программная платформа: она запускает процессы на нужных видеокартах, распределяет данные или параметры модели и организует обмен между устройствами.
В экосистеме PyTorch чаще всего используют DDP и FSDP, а для более сложных конфигураций — DeepSpeed и Hugging Face Accelerate:
PyTorch DDP
Distributed Data Parallel реализует Data Parallelism в PyTorch. Он запускает отдельный процесс на каждой GPU и синхронизирует градиенты между копиями модели. DDP используют, когда модель помещается на одну карту, а задача — ускорить обработку данных.
PyTorch FSDP
Fully Sharded Data Parallel (FSDP) позволяет распределять между GPU параметры модели, градиенты и состояния оптимизатора. Объем шардирования зависит от выбранной стратегии, но в любом случае FSDP помогает снизить расход памяти на каждой видеокарте и запускать более крупные модели.
DeepSpeed
DeepSpeed — библиотека Microsoft для распределенного обучения крупных моделей. Ее механизм ZeRO поэтапно шардирует состояния оптимизатора, градиенты и параметры. При необходимости часть данных можно выгружать в оперативную память или на NVMe.
Hugging Face Accelerate
Accelerate упрощает запуск распределенного обучения: настраивает процессы, назначение GPU и интеграцию с FSDP или DeepSpeed. Он полезен, когда нужно сократить объем служебного кода и быстрее переключаться между конфигурациями.
Как подготовить модель и данные к обучению на нескольких GPU
При обучении на нескольких GPU важно заранее настроить весь процесс: выбрать способ распределения, разделить данные между процессами, пересчитать размер батча и настроить сохранение состояния. Разберем каждый шаг по порядку.
1. Выберите способ распределения
Ориентируйтесь на текущее ограничение. Если модель помещается в VRAM одной карты, но обучение идет слишком долго, подойдет DDP. Если памяти не хватает, понадобятся FSDP, DeepSpeed или параллелизм модели.
2. Разделите данные между GPU
Каждый процесс должен получать свою часть датасета. В PyTorch с DDP для этого используют DistributedSampler.
Отдельно проверьте загрузку данных. Если DataLoader, процессор или хранилище не успевают подготавливать новые батчи, GPU будут простаивать независимо от их количества.
3. Пересчитайте размер батча
Глобальный размер батча зависит сразу от трех параметров: батча на одной GPU, количества GPU и числа шагов накопления градиентов. Его можно посчитать так: батч на одной GPU × число GPU × число шагов накопления градиентов.
Например, четыре GPU с батчем 32 и без накопления градиентов дают глобальный батч 128. Если добавить два шага накопления, он вырастет до 256.
При изменении глобального батча могут потребоваться другие настройки оптимизации. Если важно сохранить прежний режим обучения, уменьшите батч на одну GPU или число шагов накопления так, чтобы общий размер батча остался тем же.
4. Проверьте сохранение и первый запуск
В DDP состояние модели сохраняет один процесс, чтобы несколько процессов не пытались записывать один и тот же файл. В FSDP и DeepSpeed для сохранения шардированного состояния используются отдельные механизмы.
Первый запуск лучше провести на небольшом фрагменте данных. Посмотрите, загружены ли все GPU, как распределилась VRAM, сколько занимает один шаг и нормально ли меняется значение функции потерь. Если часть карт простаивает, причину стоит искать в загрузке данных, синхронизации или выбранной схеме распределения.
Почему две, четыре или восемь видеокарт не дают линейного ускорения
Несколько GPU делят вычисления между собой, но вместе с этим растут затраты на обмен данными. Карты синхронизируют градиенты, передают промежуточные результаты и иногда ждут, пока остальные закончат свою часть работы. Поэтому две GPU не дают ровно двукратного ускорения, а четыре — четырехкратного.
Потери особенно заметны, если на каждую карту приходится мало вычислений или связь между GPU работает медленно. Тогда заметная часть времени уходит на коммуникацию, и каждая следующая видеокарта дает меньший прирост скорости.
Если после добавления GPU обучение почти не ускорилось, сначала стоит проверить, чем заняты карты. Они могут ждать данные, синхронизацию или более медленный процесс. Добавлять следующие GPU имеет смысл только после того, как понятно, где именно теряется время.
Основные ошибки Multi-GPU-обучения
Если добавление GPU почти не сокращает время обучения, стоит проверить несколько типичных проблем.
Одна из частых ошибок — пытаться решить низкую производительность простым добавлением GPU. Сначала стоит посмотреть профилировщик: возможно, карты ждут DataLoader, одна GPU получает больше работы или слишком много времени уходит на синхронизацию. В таком случае новые ускорители только увеличат стоимость запуска.
Также есть и другие проблемы:
- Медленная загрузка данных. HDD и SATA SSD могут ограничивать скорость чтения, из-за чего GPU простаивают. Для больших датасетов предпочтительны NVMe SSD.
- Слишком маленький батч. На вычисления уходит мало времени, поэтому синхронизация занимает непропорционально большую часть шага.
- Неравномерная нагрузка. Одна GPU получает более тяжелые данные или больший объем вычислений. Остальные заканчивают раньше и ждут ее.
- Лишние синхронизации. Слишком частый обмен градиентами увеличивает накладные расходы, особенно при накоплении градиентов.
- Медленное межсоединение. PCIe или неудачная топология сервера могут ограничить скорость обмена между картами.
- Разные GPU в одной задаче. Синхронное обучение подстраивается под самый медленный процесс, поэтому более быстрые карты часть времени простаивают.
Найти причину помогает профилирование: сравните время вычислений и коммуникаций, работу DataLoader, загрузку GPU и длительность отдельных операций. Эти показатели покажут, где теряется производительность.
Собственный GPU-сервер или облачная инфраструктура: что выбрать
Собственный GPU-сервер оправдан при постоянной нагрузке и стабильных требованиях к оборудованию. Однако расходы не ограничиваются его покупкой и обслуживанием. Например, система NVIDIA DGX H100 может потреблять до 10,2 кВт, а DGX B200 — до 14,3 кВт. Подобное оборудование нуждается в мощной системе электропитания и охлаждения, поэтому разместить его в обычном офисе без подготовки помещения не получится. Компании также придётся учитывать постоянные расходы на электроэнергию.
Облачная инфраструктура подходит для проектов с переменной нагрузкой: ресурсы можно взять на время эксперимента, увеличить число GPU под крупную модель, а затем сократить конфигурацию.
| Собственный сервер | Облачная инфраструктура | |
|---|---|---|
| Расходы | Покупка и обслуживание оборудования | Аренда нужных ресурсов |
| Масштабирование | Требует нового оборудования | Конфигурацию можно менять быстрее |
| Контроль | Полный доступ к железу | Зависит от возможностей провайдера |
| Подходит | Для постоянной нагрузки | Для экспериментов и меняющихся задач |
В Рег.облаке доступны выделенные серверы с GPU, в том числе конфигурации с несколькими видеокартами. Подходящую конфигурацию можно подобрать с учетом количества GPU, типа соединения между ними, процессора, объема оперативной памяти и характера нагрузки.
GPU-инфраструктуру используют не только для обучения, но и для инференса уже обученных моделей. Кроме того, Рег.облако расширило инфраструктуру ускорителями NVIDIA B200 и B300: то есть GPU-инфраструктуру можно будет использовать не только для обучения, но и для инференса уже обученных моделей.В системе HGX B300 восемь ускорителей объединяют более 2 ТБ HBM3E-памяти – такие конфигурации рассчитаны на ресурсоемкие ИИ-нагрузки. Отметим, однако, что при выборе Multi-GPU-системы по-прежнему важно учитывать не только объем памяти и производительность отдельных GPU, но и способ их соединения и характер обмена данными между ускорителями.
Как оценить эффективность и стоимость Multi-GPU
Оценивайте Multi-GPU не по числу видеокарт, а по результату: сколько времени занимает обучение и сколько стоит один завершенный эксперимент. Если четыре GPU сокращают время обучения в три раза, но увеличивают расходы в четыре раза, такая конфигурация может быть невыгодной.
Начните с теста на одной GPU, а затем запустите ту же модель и тот же датасет на двух, четырех или восьми картах.
Сравнивайте одинаковые условия и фиксируйте несколько показателей:
- время полного обучения или одной эпохи;
- пропускную способность — сколько примеров или токенов система обрабатывает за секунду;
- загрузку видеокарт и расход видеопамяти;
- время одного шага обучения;
- общие расходы на GPU за весь запуск.
Пример расчета эффективности масштабирования Multi-GPU
Предположим, что обучение модели на одной GPU занимает 32 дня. Чтобы ускорить процесс, команда переходит на конфигурацию с восемью GPU. В результате время обучения сокращается до 5 дней.
Оценим, насколько эффективно используются дополнительные видеокарты.
1. Рассчитаем ускорение (Speedup)
Ускорение показывает, во сколько раз сократилось время обучения при использовании нескольких GPU.
S = T₁ / Tₙ = 32 / 5 = 6,4
Где:
- T₁ — время обучения на одной GPU;
- Tₙ — время обучения на нескольких GPU.
Таким образом, восемь GPU ускорили обучение в 6,4 раза.
2. Рассчитаем эффективность масштабирования (Scaling Efficiency)
Эффективность масштабирования показывает, насколько полученное ускорение близко к идеальному, при котором производительность растет пропорционально количеству видеокарт.
E = S / N × 100% = 6,4 / 8 × 100% = 80%
Где:
- S — полученное ускорение;
- N — количество GPU.
Эффективность масштабирования составила 80%. Это означает, что система достигла 80% от идеального линейного ускорения. Остальные 20% потенциального прироста не реализованы из-за накладных расходов, в том числе на синхронизацию и обмен данными между GPU.
Однако ускорение обучения не всегда означает снижение затрат. Чтобы оценить экономическую эффективность Multi-GPU, умножьте стоимость часа всей конфигурации на фактическое время обучения.
Вернемся к нашему примеру. Одна GPU работает 32 дня, а восемь GPU — 5 дней. Если стоимость аренды одной видеокарты в час одинакова в обеих конфигурациях, использование восьми GPU обойдется на 25% дороже: суммарное время работы ускорителей увеличится с 768 до 960 GPU-часов. При этом результат будет получен на 27 дней раньше, что может оправдать дополнительные расходы.
Сравнивайте конфигурации на одной модели и одном датасете. Так вы сможете определить, когда добавление GPU оправдано сокращением сроков обучения, а когда дополнительные ускорители дают слишком небольшой прирост производительности относительно затрат.
Высокая загрузка GPU еще не означает хорошее масштабирование. Смотрите вместе на время шага, пропускную способность, загрузку каждой GPU и время обмена между ними. Если число GPU растет, а пропускная способность почти не меняется, нужно искать узкое место в загрузке данных, синхронизации или межсоединении.
Нужен ли Multi-GPU каждому проекту
Нет, если одной видеокарты хватает по скорости и памяти, усложнять инфраструктуру нет смысла. Несколько GPU полезны, когда команда упирается в реальные ограничения одной карты и готова работать с распределенным обучением, синхронизацией и более сложной конфигурацией сервера.
Поэтому переход на Multi-GPU стоит воспринимать как следующий этап роста ML-проекта. Для начала определите конкретное ограничение, а затем подберите под него способ параллелизма и конфигурацию сервера.
Если пока непонятно, сколько GPU понадобится проекту, можно начать с облачной конфигурации. В Рег.облаке доступны GPU для обучения моделей и экспериментов, а конфигурацию можно подобрать под текущую нагрузку.
Вопрос-Ответ
Что такое Multi-GPU?
Multi-GPU — это обучение одной модели с использованием нескольких видеокарт. Нагрузка между ними распределяется по данным, параметрам модели или отдельным вычислениям.
Можно ли объединить память нескольких видеокарт?
Автоматически объединить VRAM нескольких GPU в общий пул нельзя. Но FSDP, DeepSpeed и методы параллелизма модели позволяют распределять параметры, градиенты и другие данные между картами. За счет этого модель, которая не помещается в память одной GPU, можно распределить между несколькими ускорителями.
Во сколько раз две видеокарты ускоряют обучение?
Ровно двукратное ускорение встречается редко. Часть времени уходит на синхронизацию и передачу данных между GPU, поэтому реальный прирост зависит от модели, размера батча и скорости межсоединения.
Что такое Data Parallelism?
Data Parallelism, или параллелизм данных, запускает копию модели на каждой GPU и распределяет между ними разные части батча. Затем градиенты синхронизируются, чтобы все копии модели обновлялись одинаково.
Чем Tensor Parallelism отличается от Pipeline Parallelism?
Tensor Parallelism делит между GPU вычисления внутри отдельных слоев модели. Pipeline Parallelism распределяет по видеокартам целые группы последовательных слоев.
Нужен ли NVLink для Multi-GPU?
Нет. Multi-GPU может работать через PCIe. NVLink нужен там, где между картами идет интенсивный обмен данными: более быстрое соединение сокращает время ожидания и повышает эффективность масштабирования.
Можно ли использовать разные видеокарты в одном обучении?
Технически можно, но синхронное обучение будет ориентироваться на более медленную GPU. Разный объем VRAM и производительность карт также усложняют распределение нагрузки, поэтому для одной задачи чаще используют одинаковые ускорители.
Как запустить обучение на нескольких GPU в PyTorch?
Один из стандартных вариантов — обернуть модель в DistributedDataParallel и запустить по одному процессу на каждую GPU через torchrun. Если модель не помещается на одну карту, вместо DDP можно использовать FSDP2.
Когда выгоднее арендовать несколько GPU в облаке?
Аренда подходит, если ускорители нужны на время обучения, эксперименты запускаются нерегулярно или проекту периодически требуется менять число и тип GPU. Вы платите за время использования и не покупаете оборудование под пиковую нагрузку.
Какие метрики показывают эффективность масштабирования?
Смотрите на время обучения, пропускную способность в примерах или токенах в секунду, время одного шага, загрузку GPU, расход VRAM и долю времени на обмен данными. Отдельно сравнивайте ускорение с ростом числа GPU: это покажет, насколько эффективно используются дополнительные карты.








