

За последние несколько лет рынок искусственного интеллекта заметно изменился. На заре развития нейросети использовались преимущественно в научной среде. К 2026 году искусственный интеллект стал применяться в бизнесе, аналитике, генерации контента, промышленности, медицине и финансовых технологиях. Это одна из причин, почему выросли требования к вычислительным мощностям.
В статье мы расскажем о выделенных и облачных серверах для ИИ, а также разберем их основные отличия.
Почему инфраструктура для ИИ-проектов так важна
Современные модели требуют больших объемов GPU-ресурсов, высокой скорости обработки данных и стабильной работы инфраструктуры. Ошибка на этапе выбора вычислительной платформы может привести к непредвиденному росту затрат, проблемам с масштабированием и снижению производительности.
Сегодня компании чаще всего выбирают между тремя подходами:
- выделенный сервер с собственными GPU (100% мощностей без «соседей»);
- облачная инфраструктура с доступом к GPU по подписке;
- гибридный формат, который сочетает оба варианта.
От выбора зависит скорость разработки, стоимость обслуживания, доступность ресурсов и гибкость всей ИИ-экосистемы.
Что такое выделенная инфраструктура
Физический сервер (Bare metal server) — это отдельное оборудование, которое выделено под проект и находится в распоряжении компании. Пользователь получает полный контроль над вычислительной средой, операционной системой, настройкой сети и конфигурацией GPU.
Ключевое преимущество выделенной инфраструктуры — автономность от других клиентов. Все ресурсы сервера находятся в полном распоряжении заказчика.
Если вам нужен именно такой уровень контроля и изоляции, обратите внимание на тарифы выделенного сервера в Рег.облаке. Это классический физический сервер с гарантированными ресурсами, который подходит для обучения больших моделей и работы с чувствительными данными. Все мощности такого сервера принадлежат только вашему проекту.
Чаще всего организации используют выделенные серверы для следующих типов проектов:
- крупных продакшен-систем,
- обучения больших моделей,
- инференса для больших моделей и/или большого количества запросов,
- корпоративных платформ с постоянной нагрузкой,
- хранения чувствительных данных,
- проектов с повышенными требованиями к безопасности.
Что такое облачные GPU-сервисы
Облачный GPU — это модель аренды вычислительных мощностей через удаленную платформу. Пользователь получает доступ к GPU через интернет и платит только за фактически использованные ресурсы.
В 2026 году формат Cloud GPU стал одним из самых популярных способов запуска ИИ-проектов. Компании могут быстро подключать новые GPU, тестировать разные конфигурации и масштабировать ресурсы без закупки дополнительного оборудования.
Формат GPU в облаке чаще всего используется для:
- стартапов,
- ML-команд,
- тестирования гипотез,
- краткосрочных AI-задач,
- сезонных нагрузок,
- проектов с быстро меняющимися требованиями.
Большинство облачных провайдеров предлагают готовые инструменты интеграции, автоматизации и масштабирования.
Выделенный сервер и облачный GPU: ключевые отличия
Модели работы выделенного сервера и облачного GPU, а также особенности предоставления этих услуг заметно отличаются друг от друга. Эти отличия можно условно разделить на четыре категории:
- Контроль над инфраструктурой.
- Масштабирование.
- Стоимость владения.
- Начало работы.
Разберем каждый из них подробнее.
Контроль над инфраструктурой
Выделенный сервер (Bare metal). В этом случае вы получаете полный доступ к серверу и работаете с ним самостоятельно: управляете операционной системой, устанавливаете драйверы и настраиваете сеть. Провайдер предоставляет только оборудование и условия для его стабильной работы. Такой уровень контроля над услугой необходим для нестандартных задач: например, для кастомных ядер Linux, специфических драйверов устройств, уникальных файловых систем или особых политик безопасности.
При работе с современными ИИ-моделями востребованы выделенные серверы с мощными GPU — такие можно арендовать в Рег.облаке. Доступны конфигурации с NVIDIA H100 80 ГБ и H200 141 ГБ, а также с новейшими B200 180 ГБ и B300 228 ГБ: они подойдут для обучения и инференса больших языковых моделей.
Облачный GPU (Cloud GPU). В этом случае провайдер берет на себя все заботы об инфраструктуре. Он обслуживает оборудование, обновляет платформу, мониторит состояние узлов, обеспечивает защиту и резервирует ресурсы. При этом вы можете работать через API, веб-интерфейс, готовые образы систем или предустановленные приложения.
Масштабирование
Если вам нужно масштабировать выделенный сервер, это потребует физического расширения парка оборудования. В этом случае предстоит:
- найти поставщика оборудования,
- заказать серверы и сетевые компоненты,
- настроить сеть и установить программное обеспечение.
Весь этот процесс требует времени и планирования, поэтому в случае критической нагрузки могут возникнуть перебои в работе проекта.
В случае с Cloud GPU масштабирование происходит программно, через API или панель управления. Вы можете добавить новые GPU-инстансы в несколько кликов. Платформа автоматически выделяет ресурсы, настраивает сеть и подключает хранилища. Если нагрузка снижается, вы так же быстро можете отключить дополнительные мощности. Также многие провайдеры предлагают автоматическое масштабирование (auto-scaling): при таком подходе система сама добавляет GPU при росте очереди задач и убирает их при простое.
Стоимость владения
Формат выделенного сервера наиболее выгоден, когда нагрузка на проект стабильная и высокая. Если GPU работают круглосуточно с потреблением более 60–70% ресурсов, сервер может окупиться примерно за 6–12 месяцев. Однако в таком случае вы платите регулярно, даже если в какой-либо отрезок времени с сервером никто не работает. Важно: самые высокопроизводительные GPU и индивидуальные конфигурации доступны только в таком формате аренды.
Что касается облачного формата, он выгоден при нестабильной, пиковой или экспериментальной нагрузке. Плата взимается только за фактическое время работы GPU — посекундно или поминутно. Например, если вы обучили модель за 30 часов и выключили инстанс, вы заплатили ровно за 30 часов. Эта система подойдет для MVP, исследований и сезонных задач.
Начало работы
При заказе выделенного сервера для старта проекта потребуется время, так как:
- работникам дата-центра необходимо подготовить оборудование и разместить его;
- системному администратору нужно смонтировать и настроить сервер, а также установить необходимое ПО и перенести данные.
Все эти процедуры могут занять несколько дней или даже недель.
Что касается облачного формата, начать работу можно спустя несколько минут после заказа GPU. Для этого достаточно зарегистрироваться на сайте провайдера, выбрать желаемую конфигурацию GPU и пополнить баланс услуги.
Покупка или аренда мощностей: что выгоднее
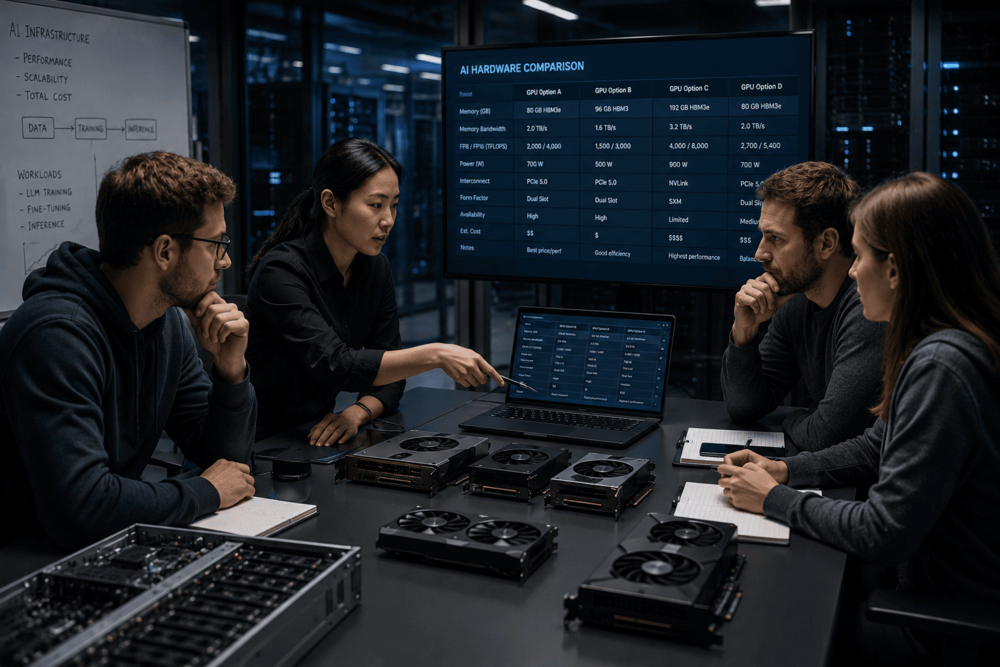
Иногда при сравнении затрат компания может обратить внимание только на стоимость самого GPU. Однако фактических расходов может оказаться значительно больше.
При покупке собственного сервера стоит учесть следующие статьи расходов:
- покупка GPU;
- серверная платформа, InfiniBand и корпус;
- электроэнергия;
- охлаждение (жидкостное или промышленное);
- обслуживание сетевой инфраструктуры и администрирование;
- замена компонентов и резервирование.
При аренде мощностей расходов значительно меньше, так как провайдер самостоятельно:
- предоставляет и обслуживает оборудование;
- выполняет резервирование и заменяет компоненты в случае их выхода из строя;
- обеспечивает питание и охлаждение в собственном дата-центре.
Какие решения выбирают компании в 2026 году
В 2026 году компании редко выбирают единственный подход: как правило, они разворачивают инфраструктуру в гибридном формате. Рассмотрим особенности некоторых отраслей.
Крупные компании
У таких компаний, как правило, есть свои серверные и инженерные команды. Они не хотят передавать важные данные другим провайдерам, поэтому хранят их на своем оборудовании. Однако в моменты пиковых нагрузок необходимо быстро добавить мощностей — тут на помощь приходит облако.
Примерное соотношение ресурсов:
| Выделенные серверы | Облако |
|---|---|
| 70% | 30% |
Стартапы и небольшие ML-команды
Основная потребность таких команд — это быстрый старт и простое масштабирование ресурсов. Поэтому проекты чаще всего полностью размещены именно в облаке.
Примерное соотношение ресурсов:
| Выделенный сервер | Облако |
|---|---|
| 10% | 90% |
Исследовательские лаборатории и университеты
В сфере науки часто требуется большой объем мощностей, но на короткое время. Поэтому для них наиболее выгодно использовать спотовые инстансы — видеокарты, которые провайдеры продают с большой скидкой, однако провайдер может ее забрать практически в любой момент.
Такой формат лучше всего подходит для исследований, в которых допустимы паузы и есть возможность сохранить промежуточные результаты.
Сервисы с круглосуточной нагрузкой
Некоторые ИИ-проекты работают без остановки, например:
- чат-боты на сайтах,
- переводчики на сайтах,
- системы распознавания лиц,
- системы рекомендаций в интернет-магазинах и многие другие.
В этом случае нагрузка на проект стабильно высока и не имеет внезапных пиков. Поэтому чаще всего такие компании покупают собственные серверы или арендуют выделенные серверы.
Выделенные и облачные серверы — одинаково полезные форматы, которые можно комбинировать между собой. Выбор стоит делать с учетом тех задач, которые необходимо выполнять на регулярной основе.
Если вам требуется аренда вычислительных мощностей, в Рег.облаке можно заказать облачные серверы с GPU. Дополнительные настройки не потребуются — вы можете приступить к работе сразу после заказа.
Частые вопросы
Почему современные ИИ-проекты требуют гибкой инфраструктуры?
Нейросети требуют особого набора ПО и настройки: из-за этого точно спрогнозировать необходимый набор мощностей не получится. Однако производительность инференса и обучения моделей напрямую зависит от мощности видеопамяти.
Гибкая инфраструктура позволяет быстро адаптироваться к изменениям проекта и скорректировать объем мощностей в пару кликов.
Какие затраты чаще всего не учитывают при покупке GPU-серверов?
Охлаждение, электроэнергия, сетевое оборудование, лицензии, резервирование, зарплата инженеров и регулярное обновление железа.
Что влияет на скорость масштабирования вычислительных ресурсов?
Доступность GPU на рынке, сетевая архитектура, возможности автоматизации и скорость физической установки.









Облако подходит для тестирования, обучения моделей, сезонных нагрузок и быстрорастущих проектов — то есть там, где нагрузка нестабильна.